‹ Terug
De bouwspecificaties
Hoe een AI-datacenter wordt gebouwd
Stel dat je een campus bouwt rondom NVIDIA GPU's. Hier is elk onderdeel dat je daarmee verplicht aan te schaffen, wie het daadwerkelijk produceert, en de software die je installeert voordat het eerste token komt — elke naam verwijst naar het bijbehorende record.
Lees deze pagina van boven naar beneden en je hebt een echte inkoopketen gevolgd: silicon → boards → racks → kabels → koeling → stroom → software → model. Dezelfde redenering geldt voor elke accelerator — wissel de eerste stap uit en de rest van de keten verandert nauwelijks.
1 De GPU zelf is een toeleveringsketen
"Een NVIDIA GPU" is eigenlijk een pakket onderdelen uit vijf landen. NVIDIA ontwerpt het en schrijft de software; vrijwel alles wat fysiek is, wordt door anderen gemaakt.
Logische dies (de rekenkracht)
TSMC 4NP process
gefabriceerd in Taiwan op machines die alleen ASML kan bouwen — ASML EUV
Is TSMC de enige keuze? Op het scherpste technologieniveau effectief wel — elk vlaggenschip AI-chip wordt er vandaag geproduceerd. De twee alternatieve uitdagers: Samsung Foundry · Intel Foundry
Behuizing (die + geheugen samengevoegd)
TSMC CoWoS Amkor ASE
de stap die in 2023–24 de wereldwijde GPU-voorraad rantsoeneerde
Boardassemblage
Foxconn Quanta
de SXM-modules en superchip-boards worden gebouwd door Taiwanese fabrikanten, niet door NVIDIA
Volledige specificatiebladen: B200 · GB200 · of de eigen keten van een chip traceren via de recordpagina.
2 Servers en racks
GPU's worden geleverd in technisch ontworpen systemen. Op Blackwell-schaal is het rack zelf het product: 18 rekentrays, 9 switch-trays, één koperen ruggengraat.
3 De bekabeling
De vraag die iedereen vergeet te stellen. Drie soorten kabel, drie leveranciersecosystemen — en op clusterschaal loopt de kabelrekening op tot honderden miljoenen.
Binnen de rack: koper
Amphenol TE Connectivity Credo
DAC en actieve elektrische kabels; de NVLink-ruggengraat van de NVL72 alleen al bestaat uit ~5.000 koperkabels — meer dan drie kilometer per rack
Tussen racks: licht
800G optics Coherent Lumentum Fabrinet
pluggbare transceivers per honderdduizend per cluster; lasers van de fotonicafabrikanten, assemblage grotendeels in Thailand
Het glas zelf
Corning
campusvezelnetwerken tellen tegenwoordig miljoenen kilometers
Leer: hoe 100.000 GPU's één computer worden →
4 Koeling — en waarom het de kaart bepaalt
Bij 120 kW per rack is luchtkoeling voorbij. Vloeistof raakt elke chip, en hoe een campus warmte afvoert, bepaalt waar hij überhaupt gebouwd kan worden.
Warmteafvoer
Rear-door HX Immersion Munters
droge koelers, torens of chillers buiten; gesloten kringlopen worden eenmalig gevuld en verbruiken nauwelijks water
Het locatiesignaal:
koeling is de reden waarom datacenters van oudsher werden gebouwd nabij rivieren en meren (verdampingsontwerpen), en waarom de nieuwe gesloten-kringloopgeneratie in plaats daarvan goedkope stroom in droge streken kan opzoeken. Scouts herkennen campussen op kaarten aan precies deze kenmerken — waterrechten, hoogspanningsroutes, glasvezelroutes, koele klimaten.
Leer: waar datacenters naartoe gaan, en waarom →
Binnen de grote spelers: hetzelfde probleem, zes antwoorden
Iedereen hierboven verkoopt aan iedereen hieronder — maar elke grote bouwer integreert de stack anders. Dit zijn de werkelijke configuraties, samengesteld uit dezelfde records als de rest van deze database.
The vertical integrator
The only player integrated from self-designed silicon to frontier model — no NVIDIA required anywhere in Gemini's path.
Rekenkracht
TPU v7 Ironwood Trillium
Its own TPUs — Ironwood for the inference era, Trillium in volume — plus NVIDIA GPUs rented out to Cloud customers.
Fabric
TPU pods Optics
3D-torus inter-chip links reconfigured by in-house optical circuit switches; the Jupiter network carries the data center.
Racks & systemen
TPU pods
Self-designed: the 9,216-chip pod, not the server, is the unit of hardware.
Koeling
Direct-to-chip
Direct liquid cooling on TPU pods since 2018 — the earliest big liquid fleet.
Vermogen
Kairos fleet Nuclear
A giant renewables book, the first corporate SMR fleet order, and restart interest.
Software
JAX XLA
Linux + Borg orchestration underneath; JAX and XLA compile straight to TPU.
The alliance at NVIDIA scale
The biggest NVIDIA buyer builds 'AI factories' for its partner's models — with its own silicon waiting in the wings.
Rekenkracht
GB200 H100 Maia 100
Frontier NVIDIA fleets — GB200 today atop huge H100 estates — with in-house Maia 100 in supporting roles.
Fabric
InfiniBand
The world's largest InfiniBand deployments, flat networks spanning whole sites.
Software
DeepSpeed ONNX Runtime
Linux + Azure's stack; DeepSpeed for training scale; ONNX for deployment.
Model & locatie
GPT-5 Fairwater Stargate
GPT-5 trains and serves on this estate; Stargate adds OpenAI's own campuses.
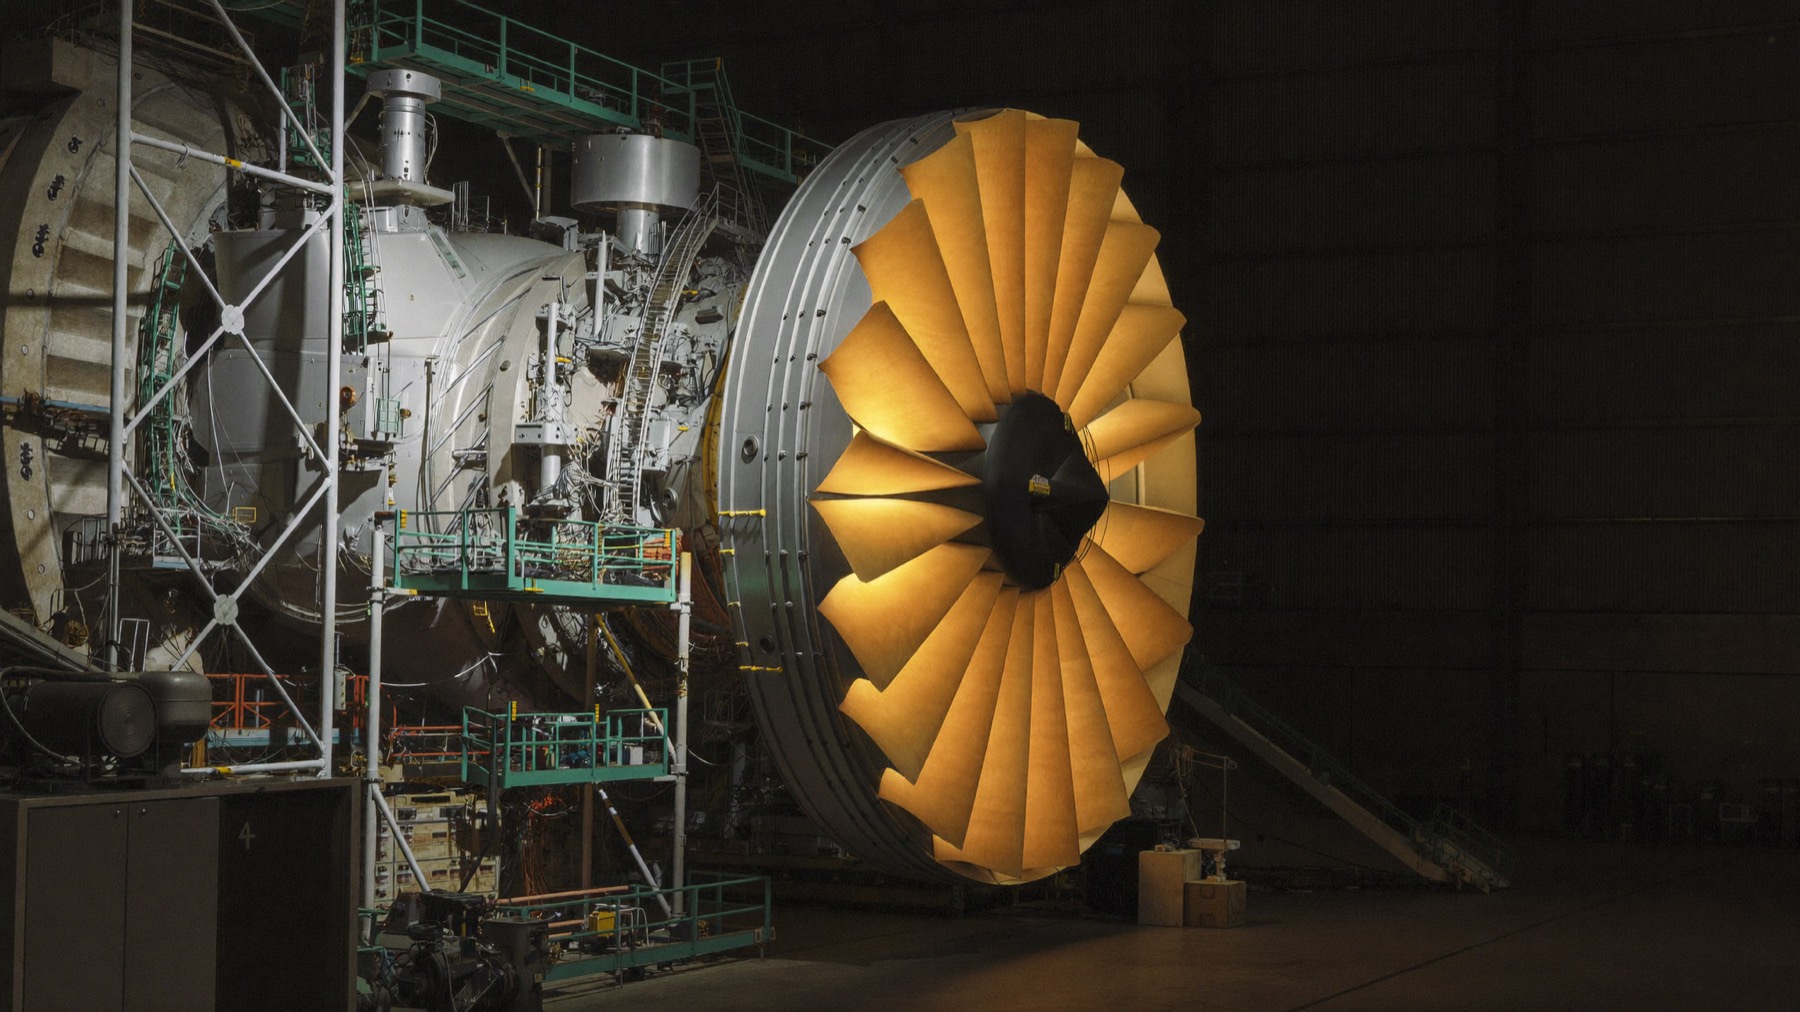
The speed record
The existence proof that a frontier cluster can be improvised in months — factory shell, gas turbines, batteries and all.
Rekenkracht
H100 H200
~100,000 H100s in 122 days, doubled since; GB200-class capacity at Colossus 2.
Fabric
Spectrum-X
The flagship Spectrum-X Ethernet deployment — NVIDIA networking without InfiniBand.
Racks & systemen
Supermicro Dell
Supermicro and Dell liquid-cooled systems, delivered at sprint pace.
Koeling
Direct-to-chip
Direct liquid throughout — the density made air a non-starter on day one.
Vermogen
Gas turbines Colossus
On-site gas turbines bridging the grid queue, Tesla Megapacks smoothing training spikes.
Software
CUDA
A lean in-house training stack on Linux and CUDA — small team, big machine.
Model & locatie
Grok 4 Colossus
Grok 3 and 4 trained at Colossus; Grok ships inside X.
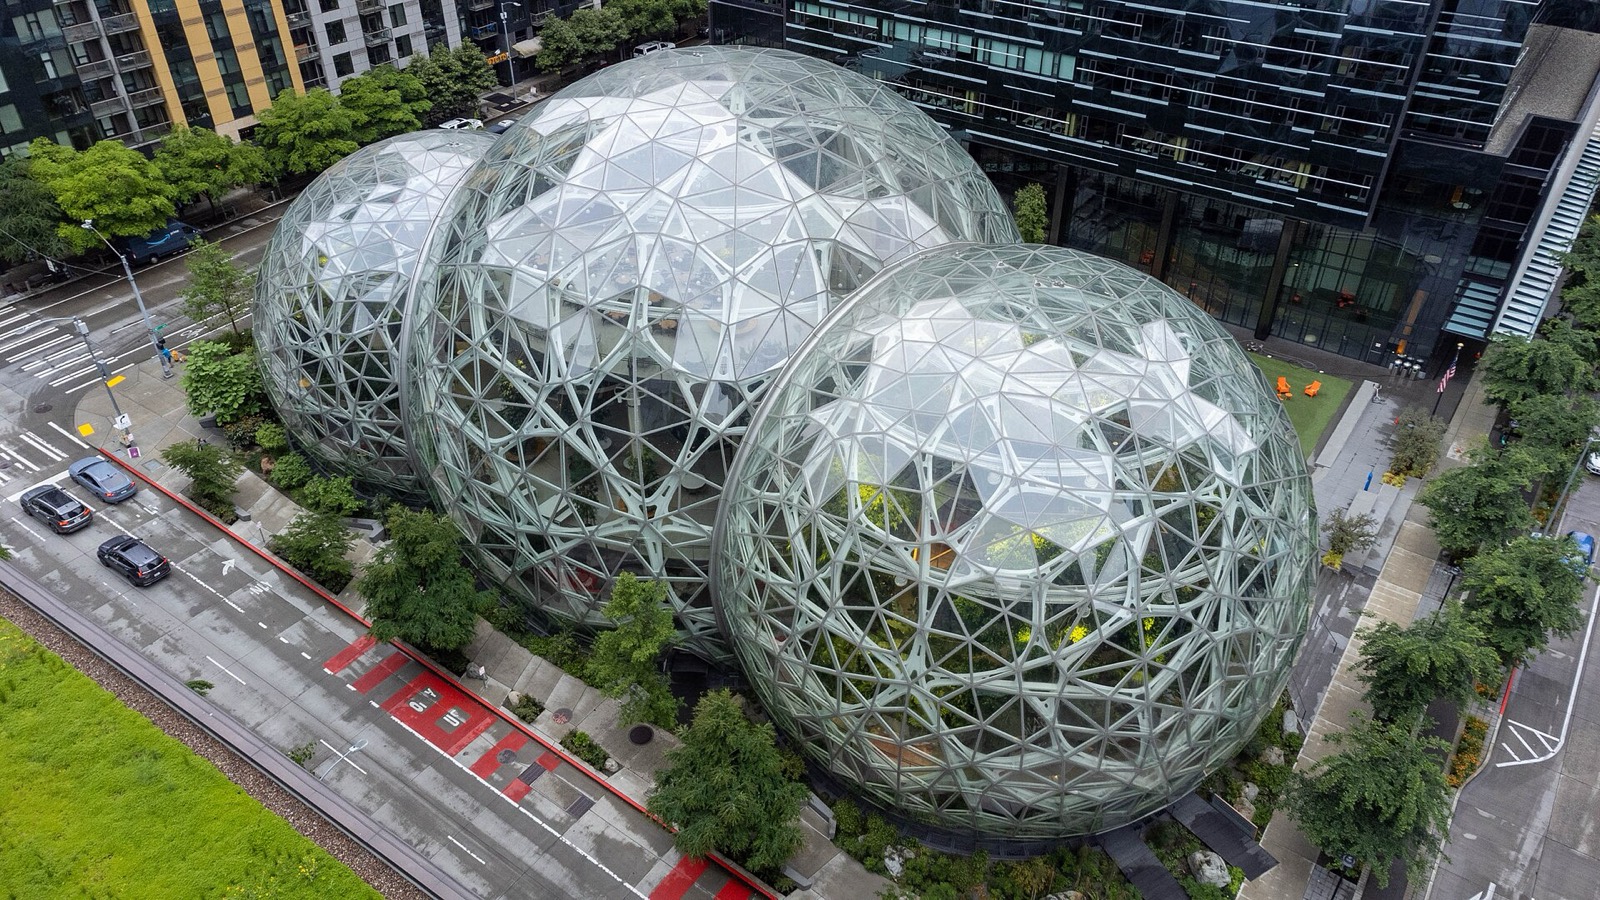
The custom-silicon bet
The clearest test of whether a hyperscaler's own chips can carry a frontier lab — half a million Trainiums and counting.
Rekenkracht
Trainium2 UltraServer
Trainium2 UltraServers at Project Rainier scale, beside NVIDIA fleets for customers.
Fabric
UltraServer
NeuronLink inside the UltraServer; AWS's own EFA networking and Nitro offload beyond it.
Racks & systemen
Annapurna/AWS
Annapurna-designed, self-integrated — the cloud primitive as the building block.
Koeling
Direct-to-chip
Liquid-and-air mix tuned per hall across the Rainier sites.
Vermogen
Susquehanna X-energy
Nuclear at Susquehanna, X-energy SMR backing, and the largest corporate renewables book.
Software
PyTorch vLLM
The Neuron SDK is the whole ballgame — porting the open stack to its own silicon.
Model & locatie
Claude 4.5 Project Rainier
Claude trains at New Carlisle — and, uniquely, also runs on TPUs and GPUs elsewhere.
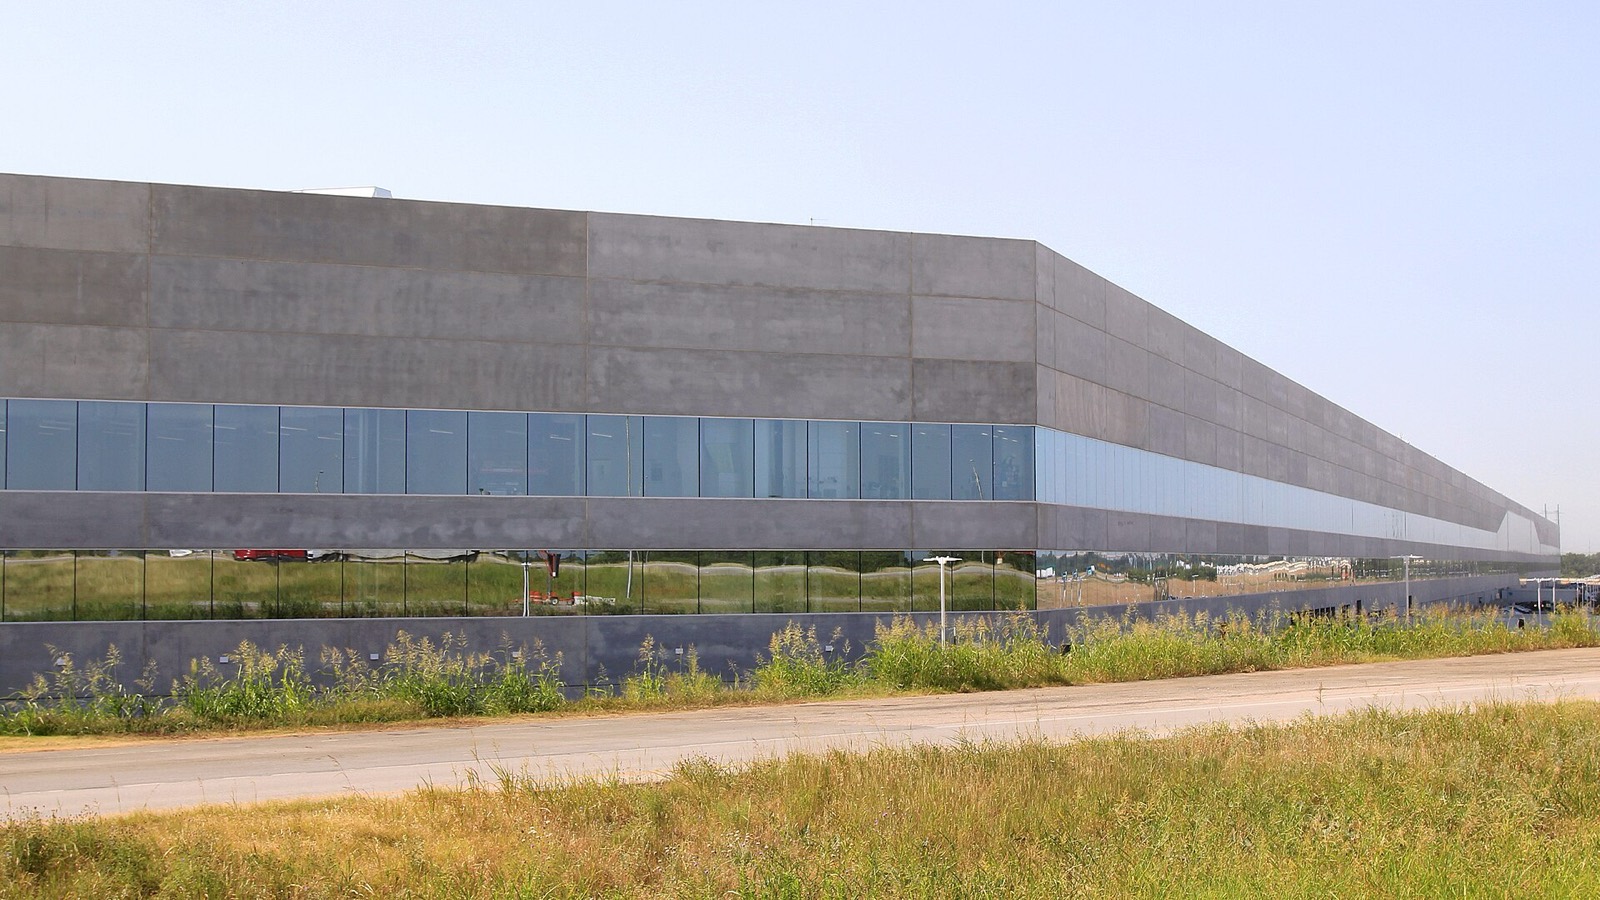
The embodied-AI factory
Trains on video from millions of cars, ships the result back to them — with its own batteries steadying its own cluster.
Rekenkracht
H100 Cortex
The ~50,000-GPU Cortex cluster at Giga Texas; Dojo wound down for AI5/AI6 chips.
Fabric
800G optics
Ethernet-fabric clusters sized for video-scale data ingest.
Racks & systemen
Supermicro
Supermicro and Dell systems, plus purpose-built data-hall extensions of the factory.
Koeling
Direct-to-chip
A dedicated liquid-cooling plant built alongside the cluster.
Vermogen
Gas turbines
Grid supply buffered by its own Megapacks — the manufacturer as its own customer.
Software
PyTorch
Vision-only training pipeline on PyTorch; models compile down to the car's FSD computer.
Model & locatie
Tesla FSD Samsung
FSD v13+ ships over the air; AI5/AI6 silicon comes from Samsung and TSMC.
Challenger-chips, de platformgeneratie van 2026–27, fotonische interconnects, de nucleaire golf en de architectuurkeuzes voorbij de transformer — bijgehouden met statuslabels op de Watchlist.