‹ Retour
La fiche technique de construction
Comment un data center IA est construit
Supposons que vous construisiez un campus autour des GPU NVIDIA. Voici chaque composant que vous venez de vous engager à acheter, qui le fabrique réellement, et le logiciel que vous installerez avant que le premier token ne sorte — chaque nom renvoie à sa fiche.
Lisez cette page de haut en bas et vous aurez suivi une vraie chaîne d'approvisionnement : silicon → cartes → racks → câbles → refroidissement → alimentation → logiciel → modèle. Le même parcours s'applique à tout accélérateur — remplacez la première étape et le reste de la chaîne change à peine.
1 Le GPU lui-même est une chaîne d'approvisionnement
« Un GPU NVIDIA » est en réalité un ensemble de composants provenant de cinq pays. NVIDIA en assure la conception et développe les logiciels ; presque tout ce qui est physique est fabriqué par d'autres.
Dies logiques (le calcul)
TSMC 4NP process
fabriqué à Taïwan sur des machines que seul ASML peut construire — ASML EUV
TSMC est-il le seul choix ? En pointe technologique, en pratique oui — chaque chip d'IA phare y est fabriqué aujourd'hui. Les deux alternatives qui cherchent à le concurrencer : Samsung Foundry · Intel Foundry
Packaging (puce + mémoire assemblées)
TSMC CoWoS Amkor ASE
l'étape qui a rationné l'approvisionnement mondial en GPU en 2023–24
Assemblage de cartes
Foxconn Quanta
les modules SXM et les cartes superchip sont fabriqués par des constructeurs taïwanais, pas par NVIDIA
Fiches techniques complètes : B200 · GB200 · ou retracer la chaîne de n'importe quel chip depuis sa page de fiche.
2 Serveurs et racks
Les GPU sont livrés au sein de systèmes conçus à cet effet. À l'échelle Blackwell, le rack lui-même est le produit : 18 plateaux de calcul, 9 plateaux de commutation, une colonne vertébrale en cuivre.
Le système à l'échelle du rack
GB200 NVL72 HGX baseboards
~120 kW par rack — la consommation d'une centaine de foyers dans l'empreinte d'une armoire
…et qui les commercialise sous sa marque
Supermicro Dell HPE Lenovo
le canal entreprise, avec contrats de service associés
Connecteurs et retimers
Amphenol TE Connectivity Astera Labs
des milliers de contacts haute vitesse par rack ; les retimers maintiennent les signaux PCIe actifs sur l'ensemble du châssis
3 Le câblage
La question que tout le monde oublie de poser. Trois types de câbles, trois écosystèmes de fournisseurs — et à l'échelle d'un cluster, la facture de câblage se chiffre en centaines de millions.
Dans le rack : cuivre
Amphenol TE Connectivity Credo
Câbles DAC et actifs électriques ; le spine NVLink du NVL72 compte à lui seul environ 5 000 câbles en cuivre — plus de trois kilomètres par rack
Entre les racks : lumière
800G optics Coherent Lumentum Fabrinet
émetteurs-récepteurs enfichables par centaines de milliers par cluster ; lasers issus des fabricants de photonique, assemblage en grande partie en Thaïlande
Le verre lui-même
Corning
les réseaux de fibres des campus atteignent désormais des millions de kilomètres
Formation : comment 100 000 GPU forment un seul ordinateur →
4 Refroidissement — et pourquoi il détermine la carte
À 120 kW par rack, le refroidissement par air est dépassé. Le liquide touche chaque puce, et la façon dont un campus évacue la chaleur détermine où il peut être construit.
Sur la puce : plaques froides
Direct-to-chip CoolIT Boyd
plaques en cuivre à microcanaux fixées sur chaque GPU, CPU et ASIC de commutateur
Évacuation de la chaleur
Rear-door HX Immersion Munters
refroidisseurs secs, tours ou groupes frigorifiques en extérieur ; les circuits fermés sont remplis une fois et consomment très peu d'eau
Le signal de localisation :
le refroidissement explique pourquoi les data centers ont historiquement été implantés près des rivières et des lacs (systèmes évaporatifs), et pourquoi la nouvelle génération en circuit fermé peut s'installer là où l'énergie est bon marché, même en région sèche. Les prospecteurs repèrent les campus sur les cartes grâce à ces mêmes indices : droits sur l'eau, corridors haute tension, tracés de fibres, climats frais.
Formation : où s'implantent les data centers, et pourquoi →
5 La salle électrique
Entre le réseau électrique et les racks se trouve un bâtiment rempli d'équipements aux délais d'approvisionnement pluriannuels — généralement le véritable chemin critique.
Appareillage de commutation, UPS, chemin de câbles
Eaton Schneider ABB Vertiv
la colonne vertébrale électrique ; les racks de nouvelle génération tendent vers une distribution en courant continu à 800 volts
Faites le calcul vous-même : le Cluster Power Calculator →
Les géants face au même problème : six approches
Tous les acteurs ci-dessus vendent à tous ceux du dessous — mais chaque grand constructeur intègre la pile différemment. Ce sont les configurations réelles, assemblées à partir des mêmes enregistrements que le reste de cette base de données.
The vertical integrator
The only player integrated from self-designed silicon to frontier model — no NVIDIA required anywhere in Gemini's path.
Calcul
TPU v7 Ironwood Trillium
Its own TPUs — Ironwood for the inference era, Trillium in volume — plus NVIDIA GPUs rented out to Cloud customers.
Fabric
TPU pods Optics
3D-torus inter-chip links reconfigured by in-house optical circuit switches; the Jupiter network carries the data center.
Racks & systèmes
TPU pods
Self-designed: the 9,216-chip pod, not the server, is the unit of hardware.
Refroidissement
Direct-to-chip
Direct liquid cooling on TPU pods since 2018 — the earliest big liquid fleet.
Alimentation
Kairos fleet Nuclear
A giant renewables book, the first corporate SMR fleet order, and restart interest.
Logiciels
JAX XLA
Linux + Borg orchestration underneath; JAX and XLA compile straight to TPU.
The alliance at NVIDIA scale
The biggest NVIDIA buyer builds 'AI factories' for its partner's models — with its own silicon waiting in the wings.
Calcul
GB200 H100 Maia 100
Frontier NVIDIA fleets — GB200 today atop huge H100 estates — with in-house Maia 100 in supporting roles.
Fabric
InfiniBand
The world's largest InfiniBand deployments, flat networks spanning whole sites.
Refroidissement
Fairwater Direct-to-chip
Closed-loop direct liquid at Fairwater — fill once, near-zero water after.
Alimentation
Crane restart Constellation
The Three Mile Island restart PPA (835 MW, 20 years) plus a 10.5 GW renewables framework.
Logiciels
DeepSpeed ONNX Runtime
Linux + Azure's stack; DeepSpeed for training scale; ONNX for deployment.
Modèle & site
GPT-5 Fairwater Stargate
GPT-5 trains and serves on this estate; Stargate adds OpenAI's own campuses.
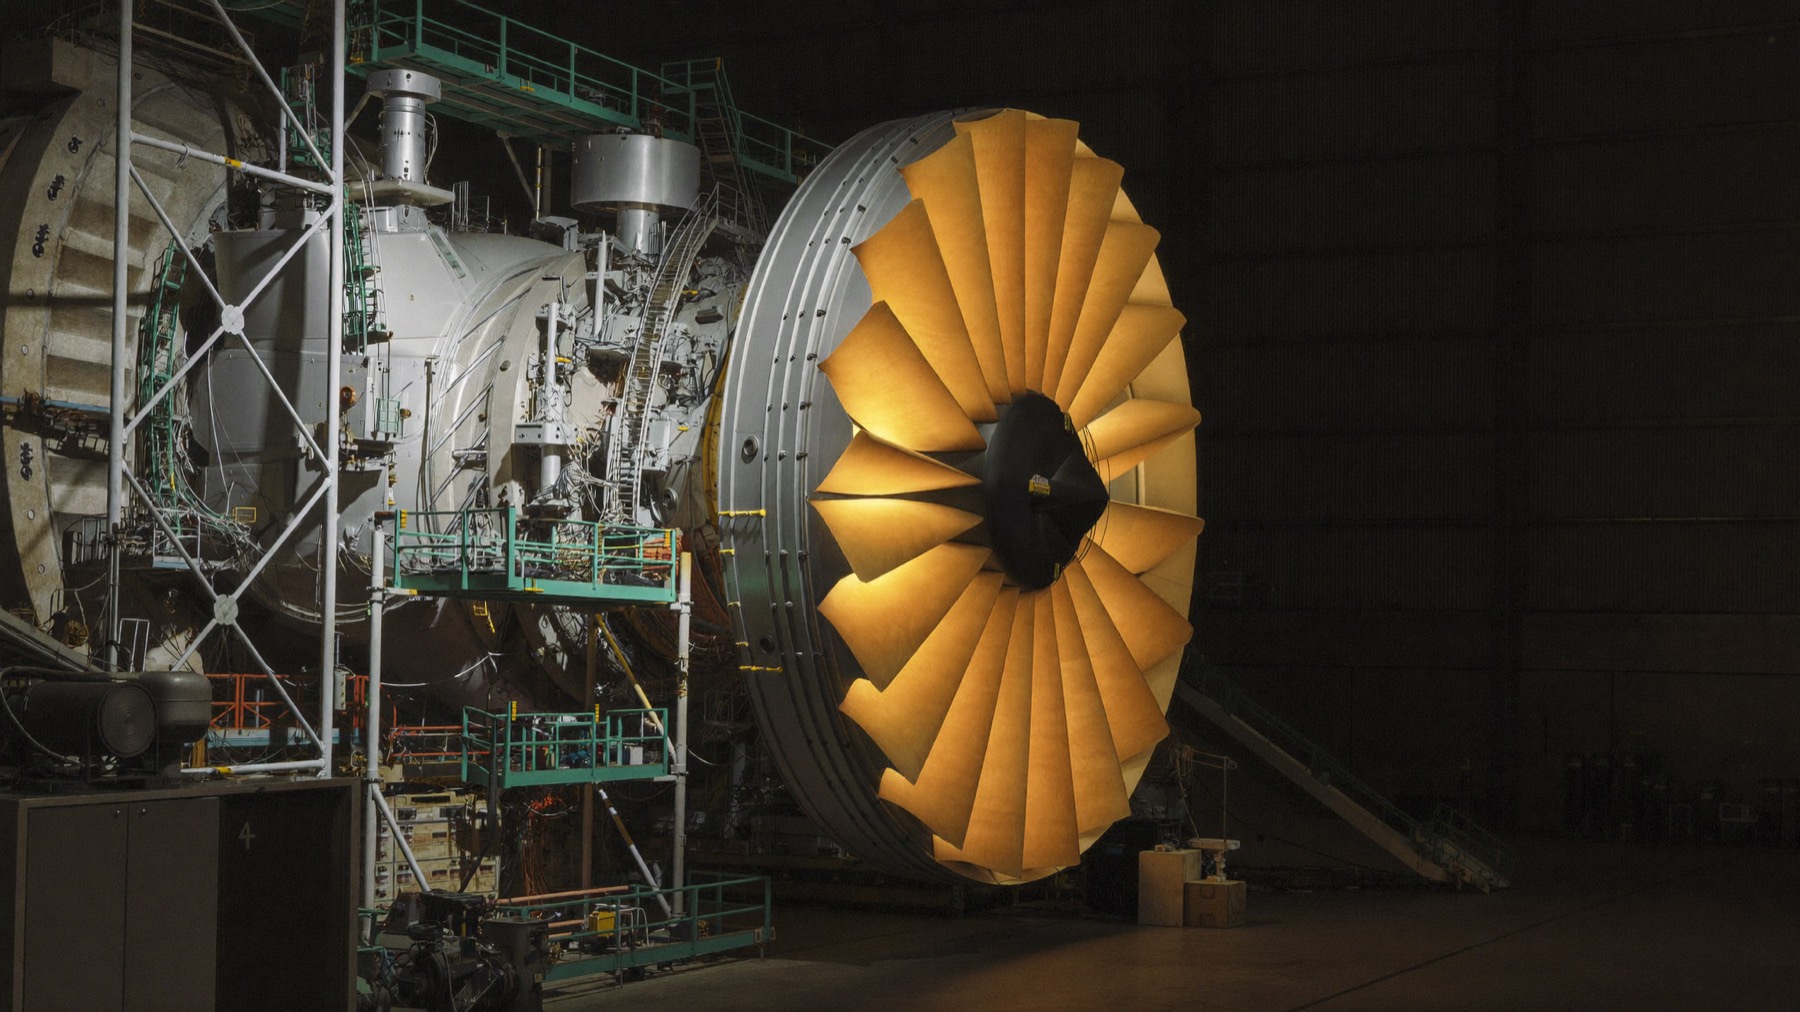
The speed record
The existence proof that a frontier cluster can be improvised in months — factory shell, gas turbines, batteries and all.
Calcul
H100 H200
~100,000 H100s in 122 days, doubled since; GB200-class capacity at Colossus 2.
Fabric
Spectrum-X
The flagship Spectrum-X Ethernet deployment — NVIDIA networking without InfiniBand.
Racks & systèmes
Supermicro Dell
Supermicro and Dell liquid-cooled systems, delivered at sprint pace.
Refroidissement
Direct-to-chip
Direct liquid throughout — the density made air a non-starter on day one.
Alimentation
Gas turbines Colossus
On-site gas turbines bridging the grid queue, Tesla Megapacks smoothing training spikes.
Logiciels
CUDA
A lean in-house training stack on Linux and CUDA — small team, big machine.
Modèle & site
Grok 4 Colossus
Grok 3 and 4 trained at Colossus; Grok ships inside X.
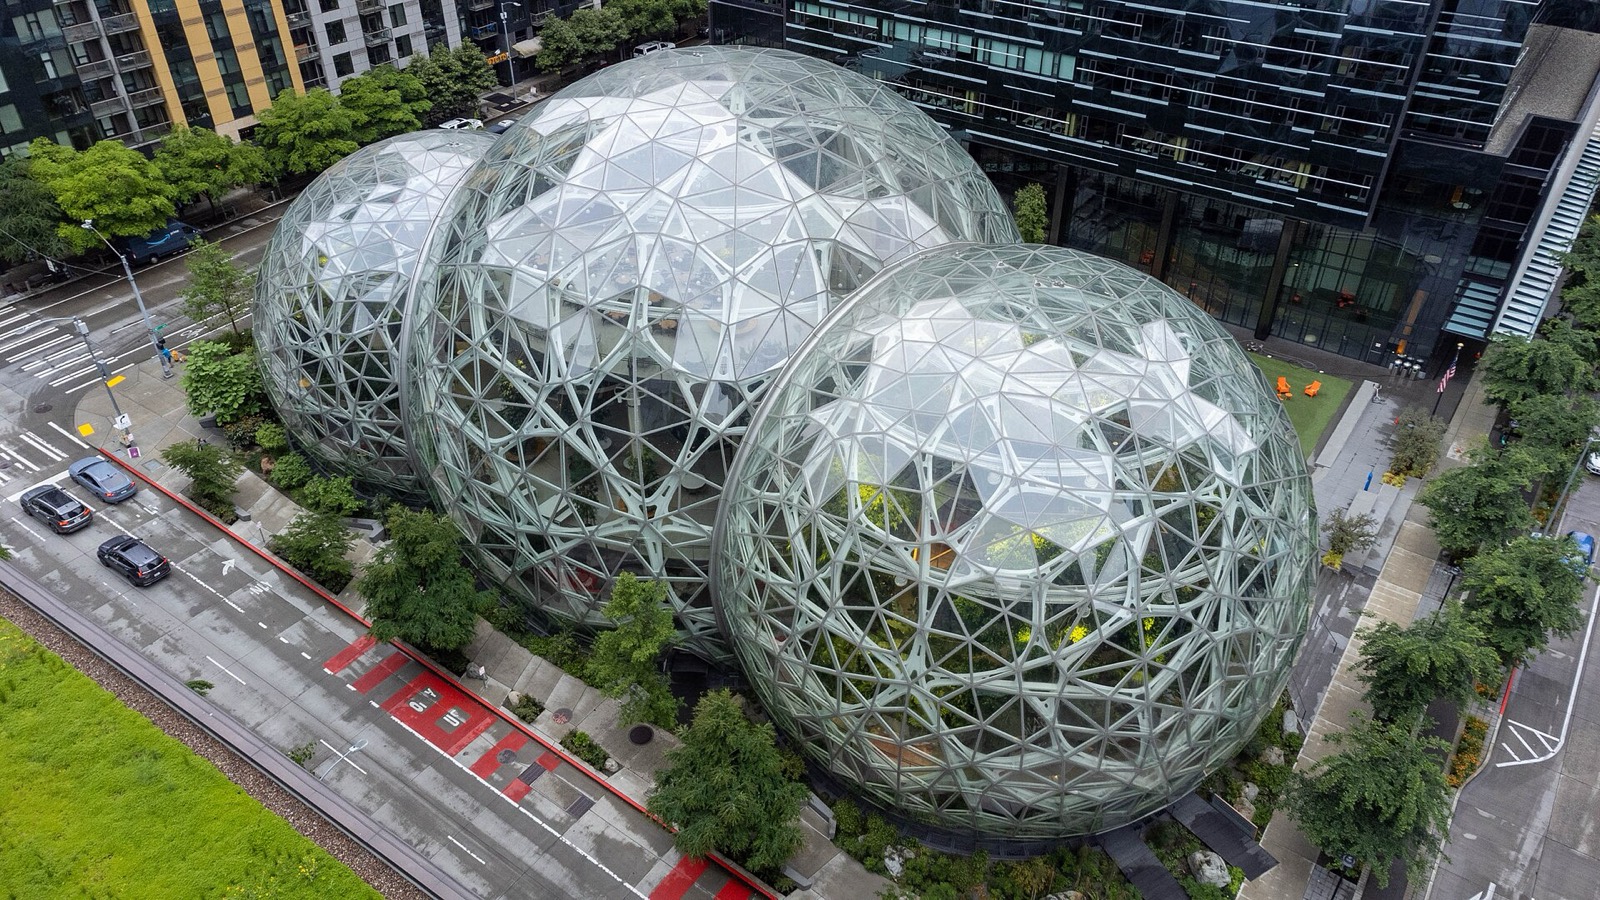
The custom-silicon bet
The clearest test of whether a hyperscaler's own chips can carry a frontier lab — half a million Trainiums and counting.
Calcul
Trainium2 UltraServer
Trainium2 UltraServers at Project Rainier scale, beside NVIDIA fleets for customers.
Fabric
UltraServer
NeuronLink inside the UltraServer; AWS's own EFA networking and Nitro offload beyond it.
Racks & systèmes
Annapurna/AWS
Annapurna-designed, self-integrated — the cloud primitive as the building block.
Refroidissement
Direct-to-chip
Liquid-and-air mix tuned per hall across the Rainier sites.
Alimentation
Susquehanna X-energy
Nuclear at Susquehanna, X-energy SMR backing, and the largest corporate renewables book.
Logiciels
PyTorch vLLM
The Neuron SDK is the whole ballgame — porting the open stack to its own silicon.
Modèle & site
Claude 4.5 Project Rainier
Claude trains at New Carlisle — and, uniquely, also runs on TPUs and GPUs elsewhere.
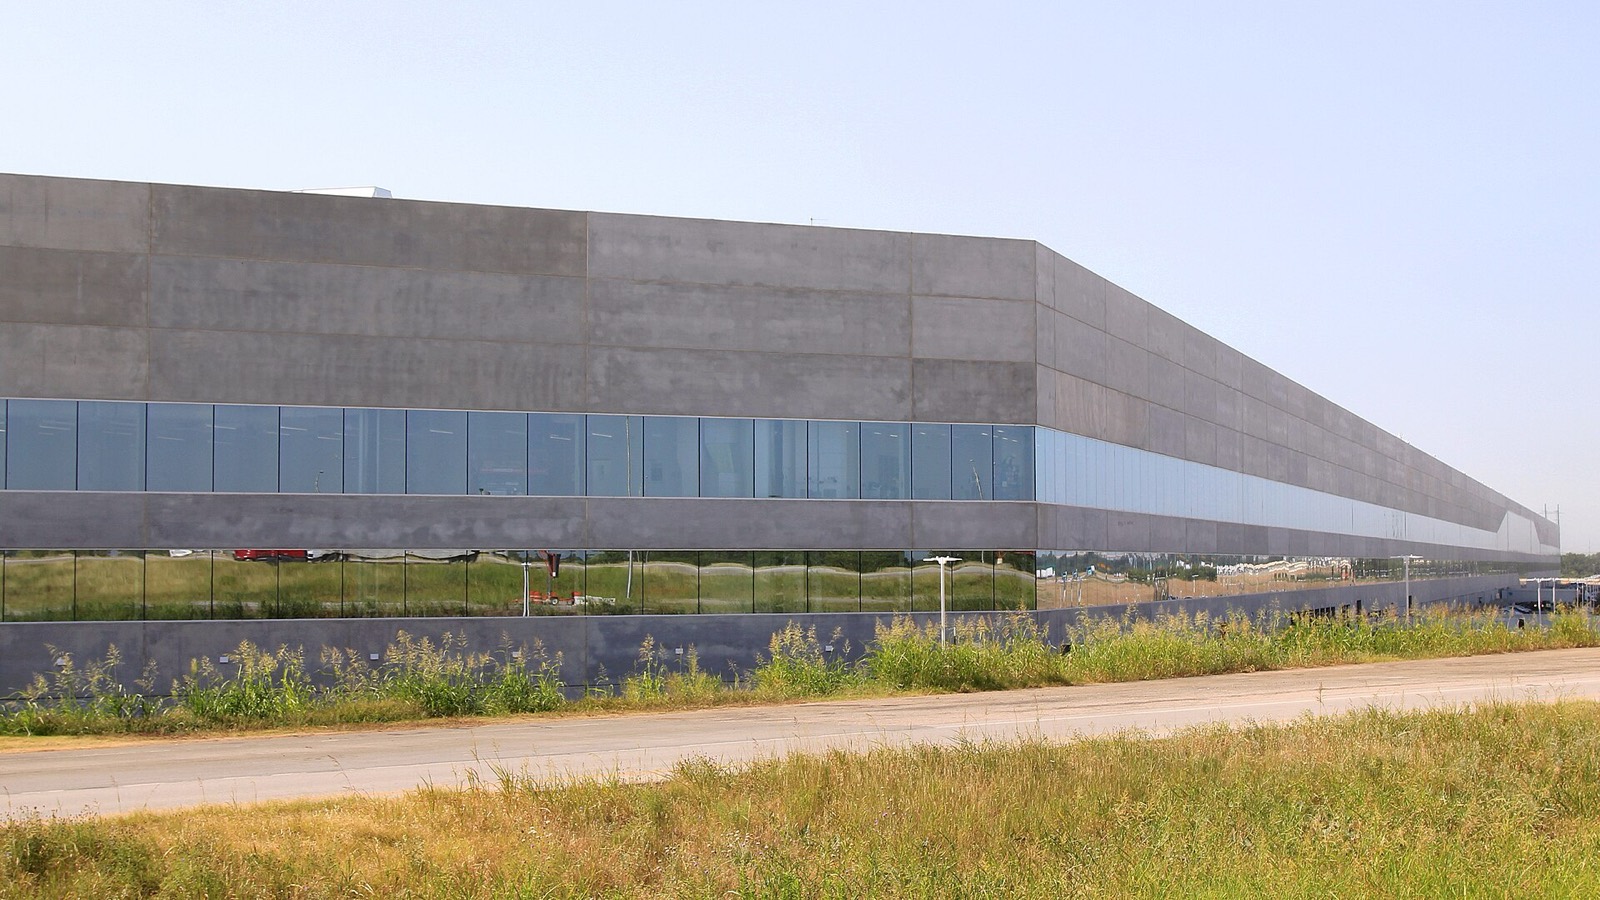
The embodied-AI factory
Trains on video from millions of cars, ships the result back to them — with its own batteries steadying its own cluster.
Calcul
H100 Cortex
The ~50,000-GPU Cortex cluster at Giga Texas; Dojo wound down for AI5/AI6 chips.
Fabric
800G optics
Ethernet-fabric clusters sized for video-scale data ingest.
Racks & systèmes
Supermicro
Supermicro and Dell systems, plus purpose-built data-hall extensions of the factory.
Refroidissement
Direct-to-chip
A dedicated liquid-cooling plant built alongside the cluster.
Alimentation
Gas turbines
Grid supply buffered by its own Megapacks — the manufacturer as its own customer.
Logiciels
PyTorch
Vision-only training pipeline on PyTorch; models compile down to the car's FSD computer.
Modèle & site
Tesla FSD Samsung
FSD v13+ ships over the air; AI5/AI6 silicon comes from Samsung and TSMC.
Le silicium concurrent, la génération de plateformes 2026–27, les interconnexions photoniques, la vague nucléaire et les paris architecturaux au-delà du transformer — suivis avec des étiquettes de statut dans la liste de veille.