★
Menu
Beranda Cara Pembuatannya Watchlist Tumpukan
Perangkat Keras ChipBandingkan Chip Server & SistemJaringan MemoriFoundri & Pengemasan Pendinginan
Fasilitas Pusat-Pusat DataDaya ProyekCloud & Komputasi GPU
Kecerdasan Model AIPerangkat Lunak Produk AIBenchmark Makalah RisetKumpulan-Kumpulan Data Konsep-Konsep
Ekosistem Perusahaan-PerusahaanSaham Orang-orangTimeline TrenMasa Depan AI
Pelajari Berita Tanya Data Agen AI
Tentang Tentang kami Metodologi Data & API Penyangkalan
Opsi
DATA & API

Akses JSON baca-saja gratis ke data cache situs.

Mode Gelap

Tampilan Terpandu
Baru mengenal chip, data center, dan jargon model? Kami menjelaskan istilah-istilah kunci saat Anda menjelajah, dalam bahasa yang mudah dipahami. Data yang sama, dilengkapi panduan bawaan.

Tampilan Ahli
Anda sudah memahami seluk-beluknya. Cukup datanya: bersih, cepat, dan ringkas, tanpa penjelasan tambahan. Ini adalah tampilan default.

Bahasa antarmuka
‹ Kembali
Beranda › Chip › Google TPU v1–v3

Google TPU v1–v3

Chip Akselerator AI Historis

The originals: the 2015 inference ASIC that started the custom-silicon era.

Anda sedang melihat entri chip: apa itu prosesor ini, spesifikasi utamanya, siapa yang merancang, memproduksi, dan memasok komponennya, serta di mana chip ini digunakan.
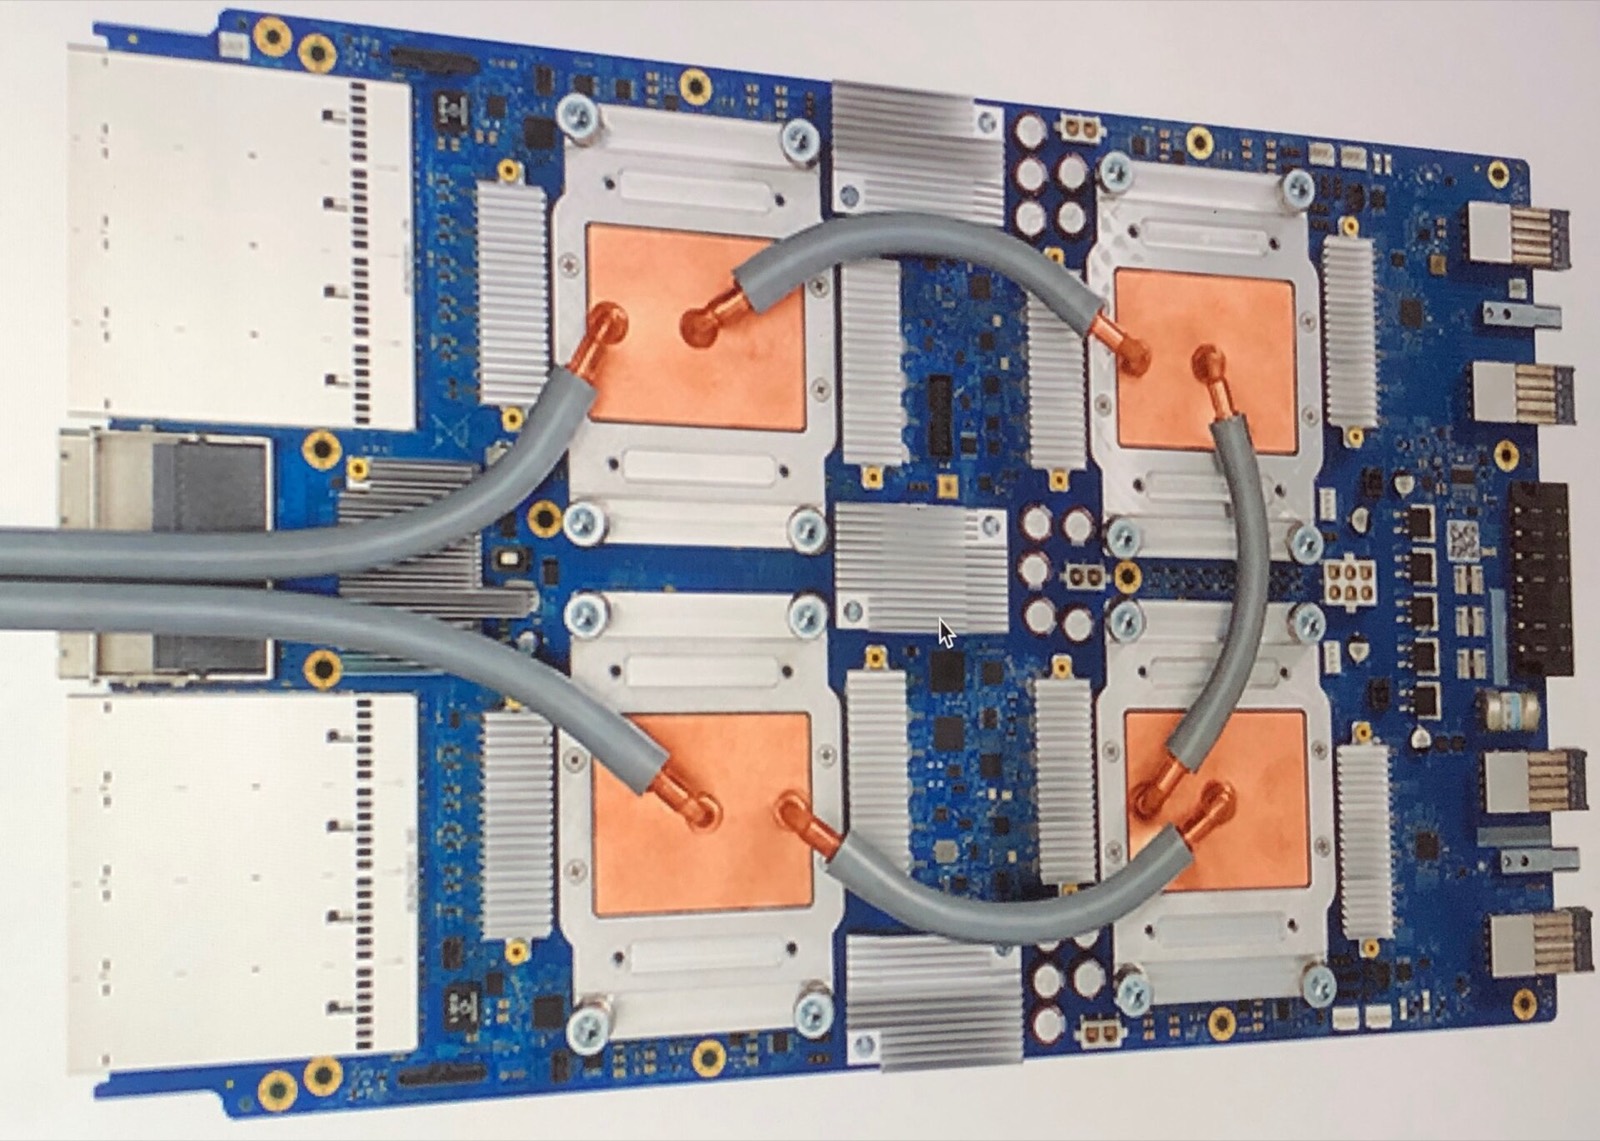
Foto: Zinskauf · CC BY-SA 4.0 · Wikimedia Commons

TPU v1 (deployed 2015, revealed 2016) was a 28 nm inference ASIC built in 15 months after Google calculated that voice search at scale would otherwise require doubling its data centers. v2 (2017) added training, HBM and the first pods; v3 (2018) went liquid-cooled at 1,024-chip scale and trained early BERT-era models. Together they proved a hyperscaler could out-build the merchant market for its own workloads — the argument every custom AI chip since has followed. AlphaGo ran on TPUs when it beat Lee Sedol in 2016.

Spesifikasi & fakta utama

Setiap angka diberi label berdasarkan sumbernya: spesifikasi vendor, klaim vendor, dilaporkan, estimasi, atau resmi. "Tidak diungkapkan secara publik" berarti tepat seperti itu — kami tidak pernah mengarang nilai.

Overview

Designer Google
Deployed v1 2015 · v2 2017 · v3 2018
Legacy Introduced BF16 to hardware and the pod-scale systems model

Komputasi

TPU v1 92 TOPS INT8, inference onlyPublished paper
TPU v2 45 TFLOPS BF16 per chip; first 256-chip podsVendor spec
TPU v3 123 TFLOPS BF16 per chip; liquid-cooled 1,024-chip podsVendor spec

Bagaimana ini terhubung ke bagian lain dari stack

Tautan catatan ini sekilas — klik grup untuk langsung menuju ke sana.

Dirancang oleh

Digunakan untuk melatih

Digantikan oleh

Sumber

TPU v1 paper (ISCA 2017) ↗

Rekaman ditinjau per 2026-01-15 — lihat Metodologi.