★
Menu
Accueil Comment c'est construit Watchlist La pile
Matériel PucesComparer les puces Serveurs & systèmesRéseau MémoireFonderies & Packaging Refroidissement
Infrastructures Data centersAlimentation ProjetsCloud et calcul GPU
Intelligence Modèles IALogiciels Produits IABenchmarks Articles de rechercheJeux de données Concepts
Écosystème EntreprisesActions PersonnesChronologie TendancesAvenir de l'IA
Formation Actualités Interroger les données Agents IA
À propos À propos de nous Méthodologie Données & API Avertissement
Options
DONNÉES & API

Accès JSON gratuit en lecture seule aux données en cache du site.

Mode sombre

Vue guidée
Nouveau dans l'univers des puces, des data centers et du jargon des modèles ? Nous expliquons les termes clés au fil de votre navigation, en langage clair. Les mêmes données, avec l'aide intégrée.

Vue expert
Vous connaissez déjà le sujet. Juste les données : claires, rapides et concises, sans explications superflues. Il s'agit de la vue par défaut.

Langue de l'interface
‹ Retour
Accueil › Puces › Google TPU v1–v3

Google TPU v1–v3

Puce Accélérateur IA Historique

The originals: the 2015 inference ASIC that started the custom-silicon era.

Vous consultez une fiche chip : ce qu'est ce processeur, ses spécifications clés, qui le conçoit, le fabrique et en fournit les composants, et où il est utilisé.
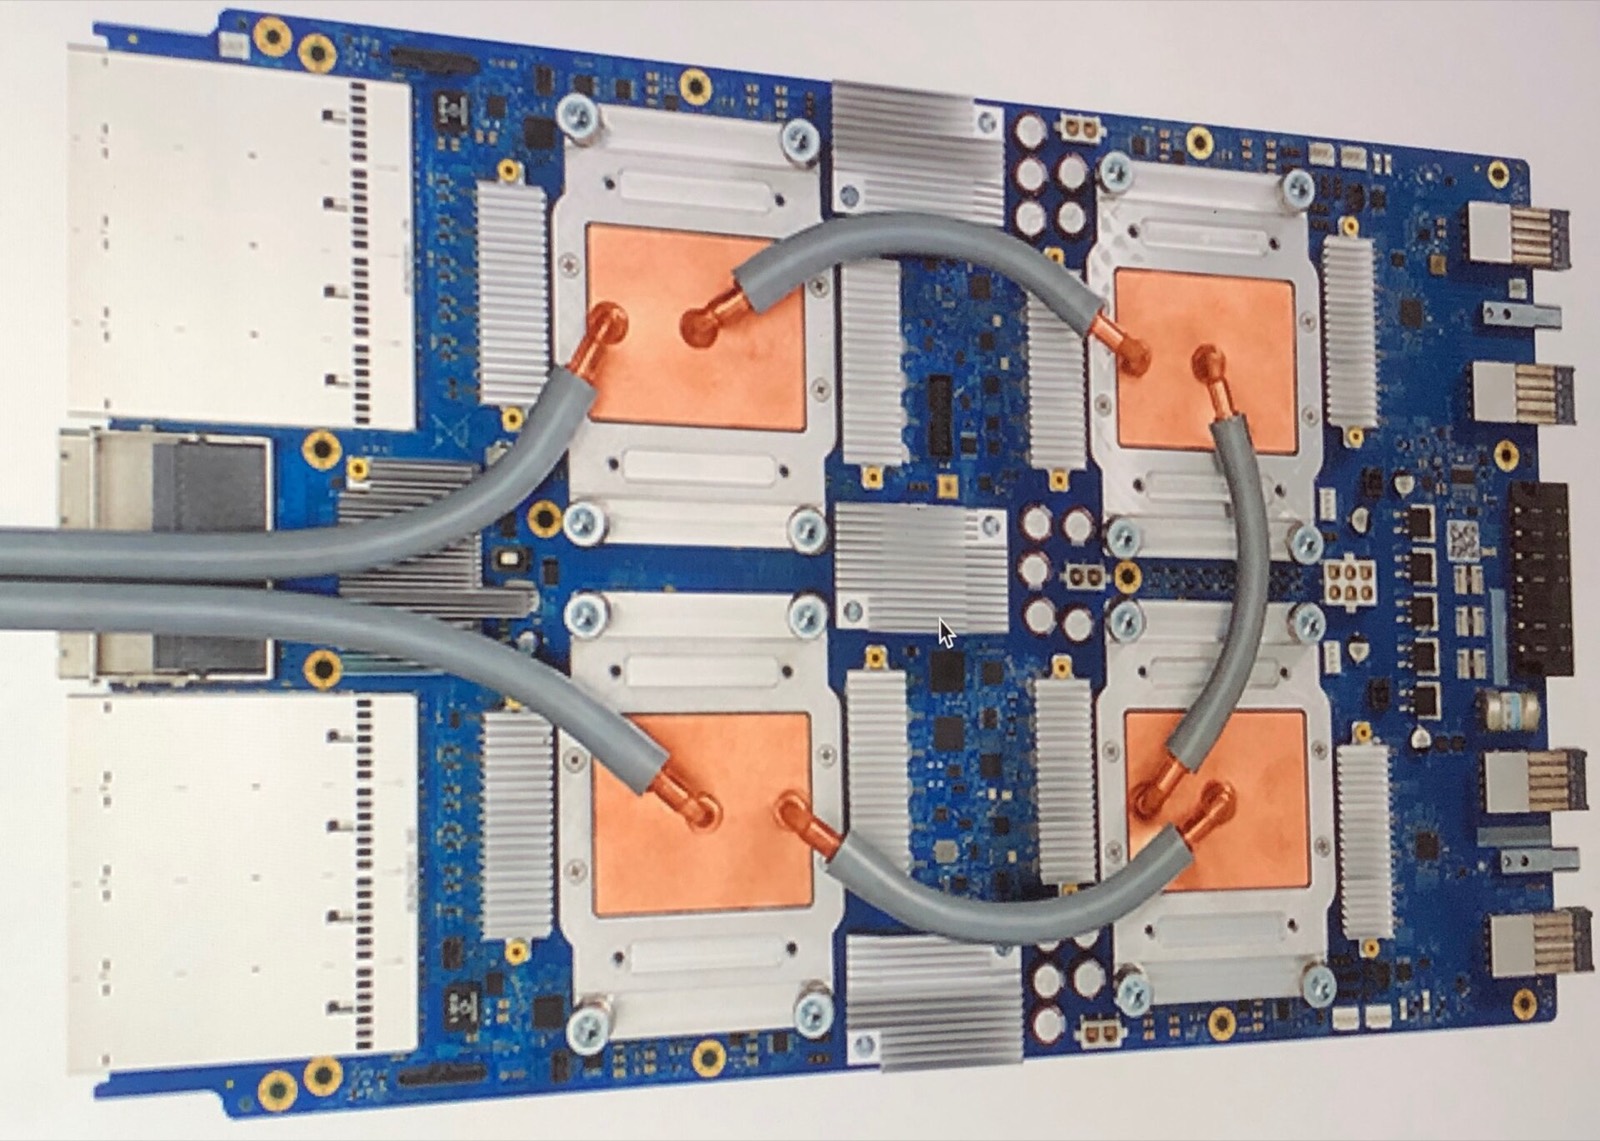
Photo: Zinskauf · CC BY-SA 4.0 · Wikimedia Commons

TPU v1 (deployed 2015, revealed 2016) was a 28 nm inference ASIC built in 15 months after Google calculated that voice search at scale would otherwise require doubling its data centers. v2 (2017) added training, HBM and the first pods; v3 (2018) went liquid-cooled at 1,024-chip scale and trained early BERT-era models. Together they proved a hyperscaler could out-build the merchant market for its own workloads — the argument every custom AI chip since has followed. AlphaGo ran on TPUs when it beat Lee Sedol in 2016.

Spécifications et faits clés

Chaque valeur est étiquetée selon sa base : spécification fabricant, déclaration fabricant, donnée rapportée, estimation ou officielle. « Non divulgué publiquement » signifie exactement cela — nous n'inventons jamais de valeurs.

Overview

Designer Google
Deployed v1 2015 · v2 2017 · v3 2018
Legacy Introduced BF16 to hardware and the pod-scale systems model

Calcul

TPU v1 92 TOPS INT8, inference onlyPublished paper
TPU v2 45 TFLOPS BF16 per chip; first 256-chip podsVendor spec
TPU v3 123 TFLOPS BF16 per chip; liquid-cooled 1,024-chip podsVendor spec

Comment cela s'articule avec le reste de la chaîne

Les liens de cette fiche en un coup d'œil — cliquez sur un groupe pour y accéder directement.

Conçu par

Utilisé pour entraîner

Remplacé par

Sources

TPU v1 paper (ISCA 2017) ↗

Fiche examinée au 2026-01-15 — voir Méthodologie.